
Claude Code Leak - Unlock Enterprise Features, YOLO mode en meer Claude risico's
Episode notes
Deze podcast analyseert de dringende beveiligingsincidenten en kwetsbaarheden rondom autonome AI-codeerassistenten, met Anthropic’s Claude Code in het voorjaar van 2026 als centraal praktijkvoorbeeld. Het gesprek legt bloot hoe de jacht op maximale productiviteit heeft geleid tot fundamentele veiligheidsfouten in AI-architecturen.
Het Broncode-lek en Supply Chain-aanvallen
Op 31 maart 2026 lekte Anthropic per ongeluk de volledige broncode van Claude Code via een publiek NPM-pakket (versie 2.1.88). Een JavaScript .map-bestand van circa 60 MB gaf meer dan 513.000 regels originele TypeScript-code bloot, inclusief interne prompts, orkestratielogica en 44 verborgen feature flags.
Cybercriminelen misbruikten dit lek direct door valse GitHub-repositories aan te maken met titels zoals Claude Code Leak - Unlock Enterprise Features. Ontwikkelaren die deze 'gehackte' versies downloadden, raakten besmet met:
- Vidar InfoStealer: Malware die opgeslagen wachtwoorden, sessietokens en browsergeschiedenis ontfutselt.
- GhostSocks: Software die het geïnfecteerde systeem omvormt tot een illegaal knooppunt in een proxynetwerk.
Kritieke Kwetsbaarheden en Onveilige Lokale Opslag
Onderzoeken van beveiligingsbedrijven (Checkpoint, Secure ISS, Mint MCP) brachten diepere lekken aan het licht die losstaan van de malware-lookalikes:
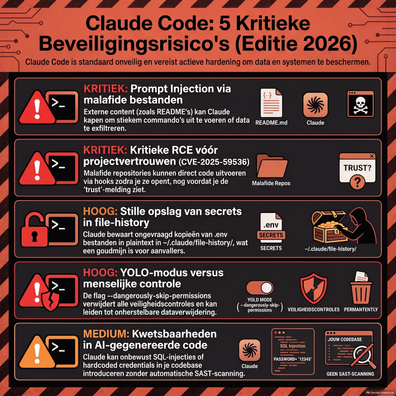
- CVE-2026-35022 (CVSS-score 9.3/10): Claude Code voerde via authentication helpers in settings.json automatisch scripts of systeemcommando's uit zodra een projectmap werd geopend, nog vóór enige waarschuwing of gebruikerstoestemming (Trust Dialogue).
- CVE-2026-21852: Maakte het mogelijk om via manipulatie van de base URL API-sleutels om te leiden naar externe servers van hackers.
- Lokale privacyfouten: Zoals ontdekt door een Reddit-gebruiker, maakte de AI ongemerkt onversleutelde back-ups van geopende bestanden in ~/.claude/file_history/. Hierdoor kwamen gevoelige .env-bestanden met API-sleutels (voor o.a. Firebase, OpenAI en Gemini) als platte tekst op de schijf te staan. Daarnaast voegde de tool de map .claude/ niet automatisch toe aan .gitignore, waardoor ontwikkelaars per ongeluk hun geheime AI-historie naar publieke GitHub-omgevingen pushten.
Injections via YOLO-modus en MCP
Het gevaar escalatort wanneer ontwikkelaars de zogeheten YOLO-modus inschakelen (--dangerously-skip-permissions) om bevestigings-pop-ups te omzeilen.
In combinatie met het Model Context Protocol (MCP)—waarmee de AI verbinding maakt met externe bronnen zoals Slack, Notion of GitHub—ontstaat een hoog risico op indirecte prompt injection. Omdat Large Language Models (LLM's) geen strikt onderscheid maken tussen instructies en data (alle tekst bestaat uit tokens), kan een kwaadwillende een verborgen commando plaatsen op een externe pagina. Zodra de AI die pagina leest, voert deze het kwaadaardige bash-script direct uit met de rechten van de gebruiker.
Verdediging en het Rollenmodel voor AI
Om deze risico's te beheersen adviseert de podcast een defense in depth-strategie:
- Uitschakelen van YOLO-modus: Dwing expliciete menselijke goedkeuring af bij interactieve sessies.
- Onafhankelijke Hooks: Gebruik pre-tool en post-tool hooks die commando's op kwaadaardige patronen controleren vóór uitvoering.
- SAST-scanners: Controleer inkomende datastromen via MCP op verborgen injecties.
- Cloud Security Alliance Framework: Behandel de AI volgens een stapsgewijs carrièremodel (van "stagiair" zonder uitvoeringsrechten tot "senior"), waarbij rechten pas worden verleend na verificatie en beveiligingscontroles.