
Local AI: Google's Gemma & Gemini in je broekzak
Episode notes
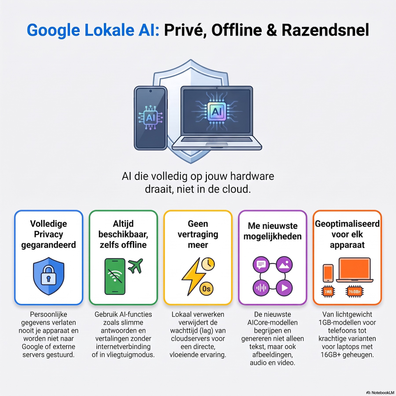
De overstap van zware cloud-servers naar lokale AI op je eigen telefoon of laptop brengt drie grote troefkaarten met zich mee: volledige privacy (data verlaat je toestel nooit), geen vertraging (zero latency) en offline werken.
1. De Onzichtbare Basis: Gemini Nano & Chrome
- Android AI Core: Een onzichtbare systeemdienst op Android (vanaf v14) die Gemini Nano aanstuurt. Functies zoals slimme antwoordsuggesties, scam-detectie en gesprekssamenvattingen werken 100% lokaal en offline.
- Chrome Built-in AI: Webontwikkelaars kunnen de lokale rekenkracht van het apparaat van de gebruiker (zoals op Chromebook Plus-modellen) rechtstreeks via de browser aanspreken. Dit bespaart serverkosten en beschermt privacy.
2. De Memory Wall & Slimme Rekenkracht
Grote AI-modellen eisen enorm veel werkgeheugen en extreme geheugenbandbreedte (>60 GB/s). Dit leidt al snel tot batterijslijtage en oververhitting op mobiele toestellen.
- Speculative Decoding (Medusa): Om rekenkracht te besparen gokt een klein mini-model razendsnel de volgende reeks woorden. Het grote model hoeft deze gok vervolgens alleen in één keer goed te keuren, wat massaal stroom en RAM-transfers bespaart.
3. Gemma: De Gespecialiseerde Gereedschapskist
In plaats van één zwaar alles-in-één model biedt Google met Gemma een reeks open-weight, gespecialiseerde modellen:
- PaliGemma: Beeld- en tekstbegrip (Vision Language Model).
- CodeGemma: Code genereren en aanvullen (Python, Java, Rust, etc.).
- MedGemma & ShieldGemma 2: Medische analyses en contentveiligheid.
- RecurrentGemma: Gebruikt de innovatieve Griffin-architectuur in plaats van Transformers, waardoor het werkgeheugen niet volloopt bij zeer lange teksten.
- Globale impact: Maakt offline onderwijs via micro-servers (Lightera) en lokale taalmodellen (Kraine AI Labs voor Swahili) mogelijk in regio's zonder stabiel internet.
4. Gemma 4 & QAT-Compressie
Gemma 4 introduceert een grote doorbraak in compressie met Quantization-Aware Training (QAT):
- Modelline-up: Variërend van E2B (native audio/video) tot 26B A4B (Mixture of Experts: activeert slechts 4B parameters per taak) en het krachtige 31B-model.
- QAT vs. PTQ: Bij traditionele compressie (PTQ) wordt een model achteraf gestript, wat leidt tot hallucinaties. Bij QAT leert het model tijdens de training al om te gaan met 2-bit/4-bit compressie. De redeneerlaag blijft intact op hoge precisie, waardoor het 31B-model ineens op 18 GB RAM past en E2B zelfs minder dan 1 GB gebruikt.
5. Zelf Aan de Slag
- Mobiel: Test modellen offline via apps zoals Google AI Edge Gallery.
- Desktop: Gebruik open-source interfaces zoals Atomic Chat, LM Studio of Ollama. Met 16 GB werkgeheugen kun je vandaag al krachtige modellen (zoals Gemma 4 12B) volledig offline laten draaien.