
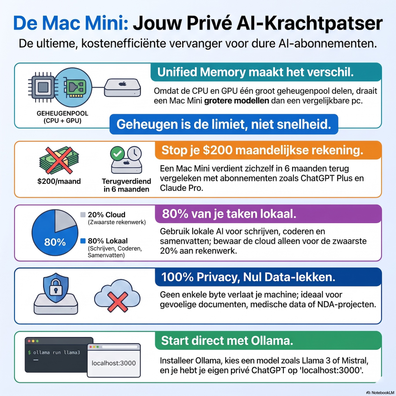
De Mac mini: jouw prive AI krachtpatser
Note sull'episodio
De podcast bespreekt de groeiende trend en de noodzaak van lokale AI als krachtig alternatief voor dure cloud-gebaseerde abonnementen zoals ChatGPT Plus en Claude Pro. De presentatoren vergelijken de huidige cloud-diensten met het huren van een dure Ferrari voor een simpel ritje naar de lokale supermarkt: je betaalt maandelijks de hoofdprijs, maar je bouwt geen enkel eigendom op. Een lokale AI-oplossing wordt daarentegen gezien als een uiterst betrouwbare, eenmalige investering die op lange termijn aanzienlijk kosten bespaart en maximale privacy garandeert.
Het centrale probleem bij het lokaal draaien van Large Language Models (LLMs) is het benodigde werkgeheugen, specifiek het Video RAM (VRAM). Traditionele pc's en peperdure gaming-videokaarten lopen hierbij tegen een keiharde grens aan. Een absoluut topmodel videokaart heeft tegenwoordig vaak maximaal 24 tot 32 GB VRAM aan boord. Zodra een geavanceerd AI-model groter is dan dit videogeheugen en de computer moet terugvallen op het tragere standaard systeemgeheugen, stort de rekensnelheid volledig in en wordt het systeem in de praktijk onwerkbaar traag.
De ideale oplossing die in deze podcast uitgebreid wordt aangedragen is de Apple Mac Mini, specifiek de modellen uitgerust met de nieuwste Apple Silicon chips. Apple maakt succesvol gebruik van een architectuur met 'Unified Memory' (volledig gedeeld geheugen). Hierdoor hebben de centrale processor (CPU) en de grafische chip (GPU) direct en razendsnel toegang tot exact dezelfde geheugenpool, zonder dat zware data continu heen en weer hoeft te worden gekopieerd. Een Mac Mini met 64 GB of zelfs 128 GB centraal werkgeheugen kan hierdoor volkomen moeiteloos gigantische AI-modellen in hun geheel inladen en lokaal draaien. Systemen die op een normale, traditionele Windows-pc direct zouden vastlopen door een gebrek aan VRAM, werken hier opmerkelijk soepel. Bovendien is de Mac Mini extreem energiezuinig en fluisterstil in gebruik.
Daarnaast bespreekt de podcast het belangrijke concept 'Quantization' (kwantisatie). Dit is een uiterst slimme compressietechniek om de wiskundige precisie van een AI-model te verlagen, bijvoorbeeld van een 16-bit naar een 4-bit weergave. Hierdoor krimpt een model dat normaal gesproken maar liefst 140 GB nodig zou hebben naar een veel beter behapbare 40 GB, met slechts een minimaal en voor de eindgebruiker nauwelijks merkbaar verlies aan kwaliteit. Dit maakt het mogelijk en betaalbaar om grote modellen lokaal te draaien.
Softwarematig is de opzet tegenwoordig verrassend eenvoudig geworden. Met gratis, open-source programma's zoals Ollama (om modellen lokaal te laten draaien) en Open WebUI (als dashboard) creëer je snel een lokale ChatGPT-ervaring, zonder dat je diepgaande technische kennis nodig hebt.
Privacy is een ander cruciaal argument. Voor professionals die dagelijks werken met medische, financiële of strikt bedrijfsgevoelige gegevens, is cloud-AI een onacceptabel risico. Met lokale AI verlaat data de computer nooit.